---
title: "Clustering Analysis"
subtitle: "Análise de clusters: features estruturais vs embeddings semânticos"
author: "Marlon"
date: today
format:
  html:
    toc: true
    toc-depth: 3
    code-fold: true
    theme: cosmo
execute:
  freeze: true
  warning: false
  echo: false
---

```{python}
#| label: setup
#| code-fold: false

import pandas as pd
import numpy as np
from pathlib import Path

# Visualização
import matplotlib.pyplot as plt
import seaborn as sns
import plotly.express as px
import plotly.graph_objects as go
from plotly.subplots import make_subplots

# Clustering (MiniBatch para eficiência de memória)
from sklearn.cluster import MiniBatchKMeans
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import silhouette_score, silhouette_samples
from sklearn.decomposition import PCA

from whatsapp.pipeline.config import PROJECT_ROOT, PATHS, PARTICIPANTES

# Arquivos de entrada
FILE_ENRICHED = PATHS['processed'] / 'messages_enriched.parquet'

# Configurações de performance
CHUNK_SIZE = 10000  # Processa 10k mensagens por vez
SAMPLE_SIZE_ELBOW = 15000  # Amostra para determinar K ótimo
BATCH_SIZE_KMEANS = 1024  # Batch size para MiniBatchKMeans

# Configurações de visualização
plt.style.use('seaborn-v0_8-whitegrid')
COLORS = {'P1': PARTICIPANTES['P1']['cor'], 'P2': PARTICIPANTES['P2']['cor']}
```

## Configuração

```{python}
#| label: config-display

# Verifica arquivos disponíveis
has_enriched = FILE_ENRICHED.exists()

# Verifica embeddings disponíveis
embedding_files = {
    'mpnet': PATHS['processed'] / 'message_embeddings_mpnet.npy',
    'minilm': PATHS['processed'] / 'message_embeddings_minilm.npy',
    'distiluse': PATHS['processed'] / 'message_embeddings_distiluse.npy'
}
embeddings_found = [k for k, v in embedding_files.items() if v.exists()]

config_data = [
    {'Dataset': '<code>messages_enriched.parquet</code>', 'Status': '✅ Disponível' if has_enriched else '❌ Não encontrado', 'Uso': 'Clustering Estrutural'},
    {'Dataset': '<code>message_embeddings_*.npy</code>', 'Status': f'✅ {len(embeddings_found)} modelo(s)' if embeddings_found else '⚠️ Opcional', 'Uso': 'Clustering Semântico'},
]

display(pd.DataFrame(config_data).style.hide(axis='index'))

# Mostra config de performance
perf_data = [
    {'Parâmetro': 'Amostra para Elbow/Silhouette', 'Valor': f'{SAMPLE_SIZE_ELBOW:,}'},
    {'Parâmetro': 'Batch size (MiniBatchKMeans)', 'Valor': f'{BATCH_SIZE_KMEANS:,}'},
    {'Parâmetro': 'Chunk size (processamento)', 'Valor': f'{CHUNK_SIZE:,}'},
]
print("\n⚡ Configurações de Performance:")
display(pd.DataFrame(perf_data).style.hide(axis='index'))
```

------------------------------------------------------------------------

# Introdução

Este notebook explora **duas abordagens de clustering** para identificar padrões nas conversas:

1. **Clustering Estrutural** — Usa features numéricas derivadas (temporais, texto, conversação)
2. **Clustering Semântico** — Usa embeddings de modelos de linguagem

A comparação entre as duas abordagens revela insights complementares:
- Estrutural captura **comportamento** (quando, como, quanto)
- Semântico captura **conteúdo** (o que, significado)

::: {.callout-note}
## Otimização de Memória
Este notebook usa **MiniBatchKMeans** e **amostragem estratificada** para processar grandes volumes de dados sem estourar memória.
:::

------------------------------------------------------------------------

# 1. Carregamento dos Dados

```{python}
#| label: load-data
#| output: false

# Carrega dataset enriquecido
df = pd.read_parquet(FILE_ENRICHED)

# Estatísticas básicas
n_mensagens = len(df)
n_colunas = len(df.columns)
periodo_inicio = df['timestamp'].min().strftime('%d/%m/%Y')
periodo_fim = df['timestamp'].max().strftime('%d/%m/%Y')
```

```{python}
#| label: data-summary

dados_resumo = [
    {'Métrica': 'Mensagens', 'Valor': f'{n_mensagens:,}'},
    {'Métrica': 'Colunas', 'Valor': f'{n_colunas}'},
    {'Métrica': 'Período', 'Valor': f'{periodo_inicio} → {periodo_fim}'},
]

display(pd.DataFrame(dados_resumo).style.hide(axis='index'))
```

------------------------------------------------------------------------

# 2. Clustering Estrutural (Features Derivadas)

Agrupa mensagens usando features numéricas criadas no Feature Engineering.

## 2.1 Seleção de Features

```{python}
#| label: select-features
#| output: false

# Features numéricas para clustering
# Excluímos: IDs, timestamps, textos, categorias não-ordinais

FEATURES_TEMPORAIS = [
    'hora', 'dia_semana_num', 'mes', 'fim_de_semana', 'horario_comercial'
]

FEATURES_TEXTO = [
    'tamanho_caracteres', 'tamanho_palavras',
    'tem_emoji', 'qtd_emojis', 'tem_link',
    'tem_interrogacao', 'tem_exclamacao', 'eh_caixa_alta'
]

FEATURES_CONVERSACAO = [
    'tempo_desde_ultima_msg', 'eh_resposta_rapida',
    'sequencia_mesmo_remetente', 'eh_inicio_conversa'
]

# Combina todas as features
FEATURES_CLUSTERING = FEATURES_TEMPORAIS + FEATURES_TEXTO + FEATURES_CONVERSACAO

# Verifica quais existem no dataset
features_disponiveis = [f for f in FEATURES_CLUSTERING if f in df.columns]
features_faltando = [f for f in FEATURES_CLUSTERING if f not in df.columns]

# Adiciona dia_semana_num se não existir
if 'dia_semana_num' not in df.columns and 'dia_semana' in df.columns:
    dia_map = {'Segunda': 0, 'Terça': 1, 'Quarta': 2, 'Quinta': 3, 'Sexta': 4, 'Sábado': 5, 'Domingo': 6}
    df['dia_semana_num'] = df['dia_semana'].map(dia_map)
    if 'dia_semana_num' not in features_disponiveis:
        features_disponiveis.append('dia_semana_num')
```

```{python}
#| label: show-features

features_info = []
for cat, feats in [('Temporais', FEATURES_TEMPORAIS),
                   ('Texto', FEATURES_TEXTO),
                   ('Conversação', FEATURES_CONVERSACAO)]:
    for f in feats:
        status = '✅' if f in features_disponiveis else '❌'
        features_info.append({'Categoria': cat, 'Feature': f'<code>{f}</code>', 'Status': status})

display(pd.DataFrame(features_info).style.hide(axis='index'))
```

```{python}
#| label: prepare-clustering-data
#| output: false

# Prepara matriz de features
df_cluster = df[features_disponiveis].copy()

# Processa cada coluna individualmente
for col in df_cluster.columns:
    # Converte categorias para numérico
    if df_cluster[col].dtype.name == 'category':
        df_cluster[col] = df_cluster[col].cat.codes

    # Converte booleanos para int
    elif df_cluster[col].dtype == bool:
        df_cluster[col] = df_cluster[col].astype(int)

    # Substitui infinitos por NaN
    df_cluster[col] = df_cluster[col].replace([np.inf, -np.inf], np.nan)

    # Preenche NaN com mediana (só para numéricos)
    if df_cluster[col].isna().any():
        df_cluster[col] = df_cluster[col].fillna(df_cluster[col].median())

# Padroniza features (Z-score)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(df_cluster)

n_features_usadas = len(features_disponiveis)
```

Features disponíveis para clustering: `{python} n_features_usadas`

## 2.2 Determinação do Número de Clusters

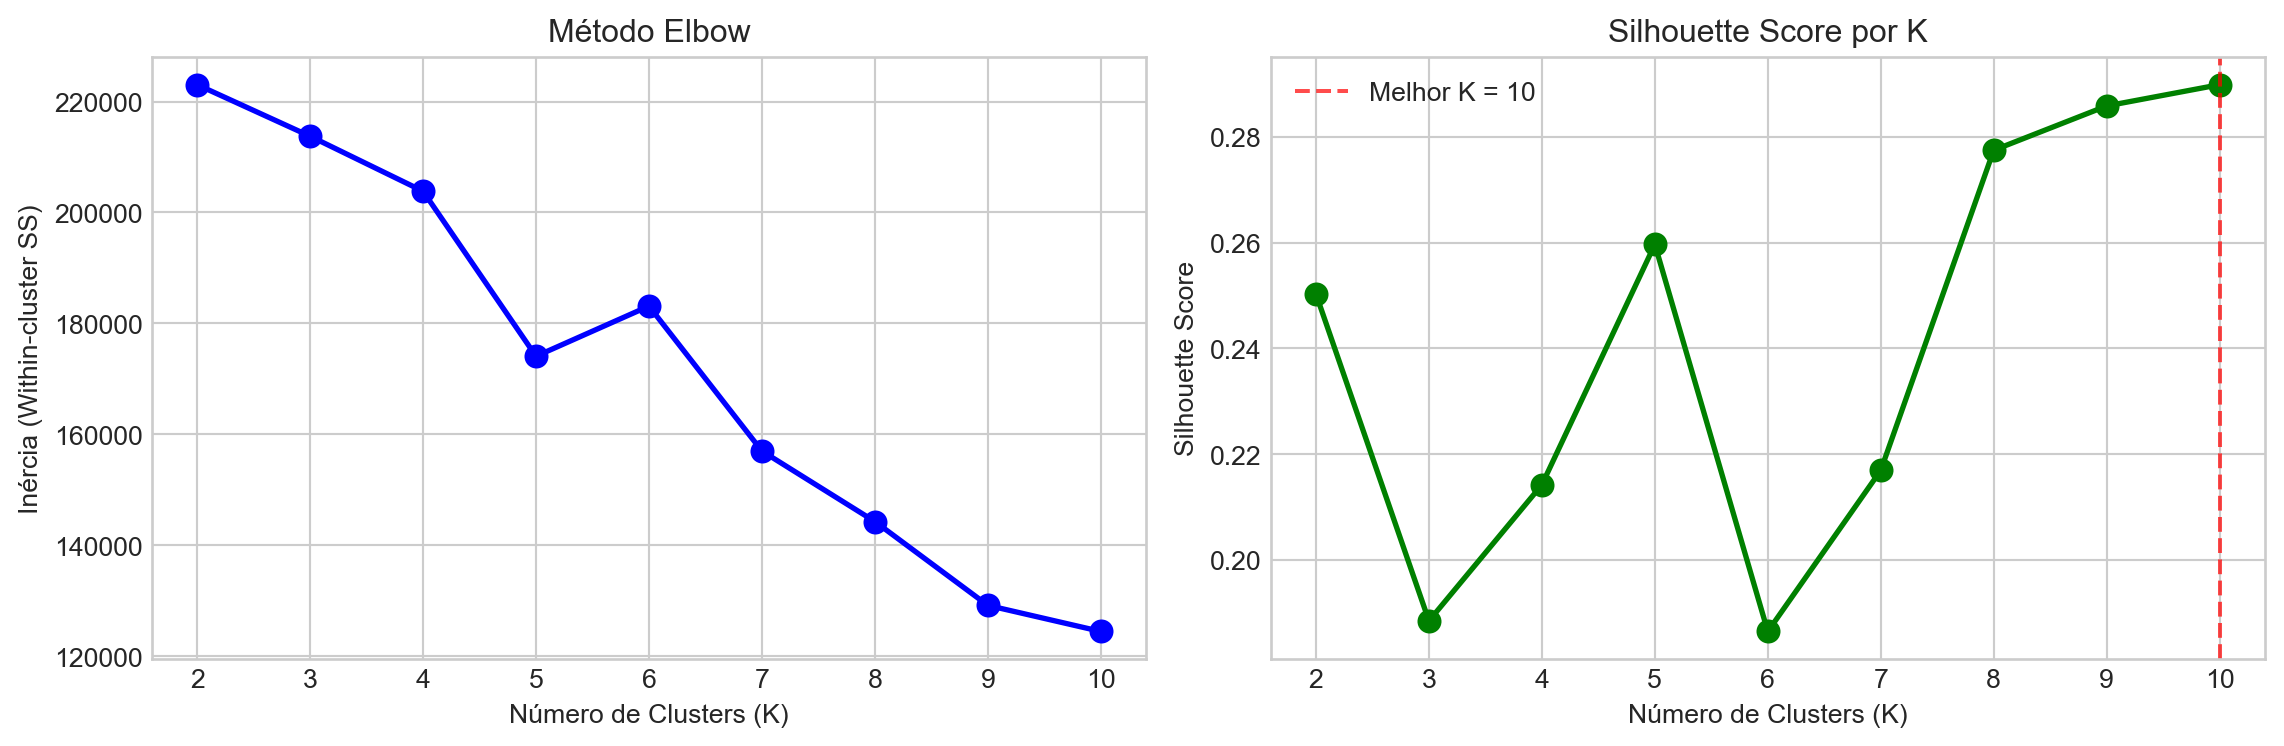
```{python}
#| label: elbow-silhouette
#| fig-cap: "Método Elbow e Silhouette Score para determinar número ótimo de clusters"

# Usa amostra estratificada para determinar K (economiza memória)
n_total = len(X_scaled)
sample_size = min(SAMPLE_SIZE_ELBOW, n_total)

# Amostra aleatória para análise
np.random.seed(42)
sample_idx = np.random.choice(n_total, sample_size, replace=False)
X_sample = X_scaled[sample_idx]

print(f"📊 Usando amostra de {sample_size:,} mensagens para determinar K ótimo")
print(f"   (de {n_total:,} total - {sample_size/n_total*100:.1f}%)\n")

# Testa diferentes números de clusters com MiniBatchKMeans
K_range = range(2, 11)
inertias = []
silhouettes = []

for k in K_range:
    # MiniBatchKMeans é ~10x mais rápido e usa menos memória
    kmeans = MiniBatchKMeans(
        n_clusters=k,
        random_state=42,
        batch_size=min(BATCH_SIZE_KMEANS, sample_size),
        n_init=3  # Menos inicializações para velocidade
    )
    labels = kmeans.fit_predict(X_sample)
    inertias.append(kmeans.inertia_)
    silhouettes.append(silhouette_score(X_sample, labels))

# Plot
fig, axes = plt.subplots(1, 2, figsize=(12, 4))

# Elbow
axes[0].plot(list(K_range), inertias, 'bo-', linewidth=2, markersize=8)
axes[0].set_xlabel('Número de Clusters (K)')
axes[0].set_ylabel('Inércia (Within-cluster SS)')
axes[0].set_title('Método Elbow')
axes[0].set_xticks(list(K_range))

# Silhouette
axes[1].plot(list(K_range), silhouettes, 'go-', linewidth=2, markersize=8)
axes[1].set_xlabel('Número de Clusters (K)')
axes[1].set_ylabel('Silhouette Score')
axes[1].set_title('Silhouette Score por K')
axes[1].set_xticks(list(K_range))

# Marca o melhor K
best_k = list(K_range)[np.argmax(silhouettes)]
axes[1].axvline(x=best_k, color='red', linestyle='--', alpha=0.7, label=f'Melhor K = {best_k}')
axes[1].legend()

plt.tight_layout()
plt.show()

print(f"📊 Melhor K pelo Silhouette Score: {best_k}")
```

## 2.3 Clustering Final

```{python}
#| label: final-clustering
#| output: false

# Usa o melhor K (ou permite override manual)
K_ESTRUTURAL = best_k  # Altere aqui se quiser testar outro valor

# Executa MiniBatchKMeans no dataset completo
# Processa em chunks para economizar memória
kmeans_estrutural = MiniBatchKMeans(
    n_clusters=K_ESTRUTURAL,
    random_state=42,
    batch_size=BATCH_SIZE_KMEANS,
    n_init=3
)

# Fit em chunks
n_chunks = (len(X_scaled) + CHUNK_SIZE - 1) // CHUNK_SIZE
for i in range(n_chunks):
    start_idx = i * CHUNK_SIZE
    end_idx = min((i + 1) * CHUNK_SIZE, len(X_scaled))
    chunk = X_scaled[start_idx:end_idx]
    kmeans_estrutural.partial_fit(chunk)

# Predict em chunks para economizar memória
labels = []
for i in range(n_chunks):
    start_idx = i * CHUNK_SIZE
    end_idx = min((i + 1) * CHUNK_SIZE, len(X_scaled))
    chunk = X_scaled[start_idx:end_idx]
    labels.extend(kmeans_estrutural.predict(chunk))

df['cluster_estrutural'] = labels

# Calcula silhouette score usando amostra (silhouette_samples é muito pesado)
sample_for_silhouette = min(10000, len(X_scaled))
sil_idx = np.random.choice(len(X_scaled), sample_for_silhouette, replace=False)
score_estrutural = silhouette_score(X_scaled[sil_idx], np.array(labels)[sil_idx])
```

```{python}
#| label: clustering-result

result_data = [
    {'Métrica': 'Número de Clusters', 'Valor': f'{K_ESTRUTURAL}'},
    {'Métrica': 'Silhouette Score (amostra)', 'Valor': f'{score_estrutural:.3f}'},
    {'Métrica': 'Interpretação', 'Valor': 'Bom' if score_estrutural > 0.5 else 'Moderado' if score_estrutural > 0.25 else 'Fraco'},
]

display(pd.DataFrame(result_data).style.hide(axis='index'))
```

## 2.4 Distribuição dos Clusters

```{python}
#| label: cluster-distribution
#| fig-cap: "Distribuição de mensagens por cluster estrutural"

cluster_counts = df['cluster_estrutural'].value_counts().sort_index()

fig = px.bar(
    x=cluster_counts.index,
    y=cluster_counts.values,
    labels={'x': 'Cluster', 'y': 'Quantidade de Mensagens'},
    title='Distribuição por Cluster Estrutural',
    color=cluster_counts.index.astype(str),
    color_discrete_sequence=px.colors.qualitative.Set2
)
fig.update_layout(showlegend=False, xaxis_tickmode='linear')
fig.show()
```

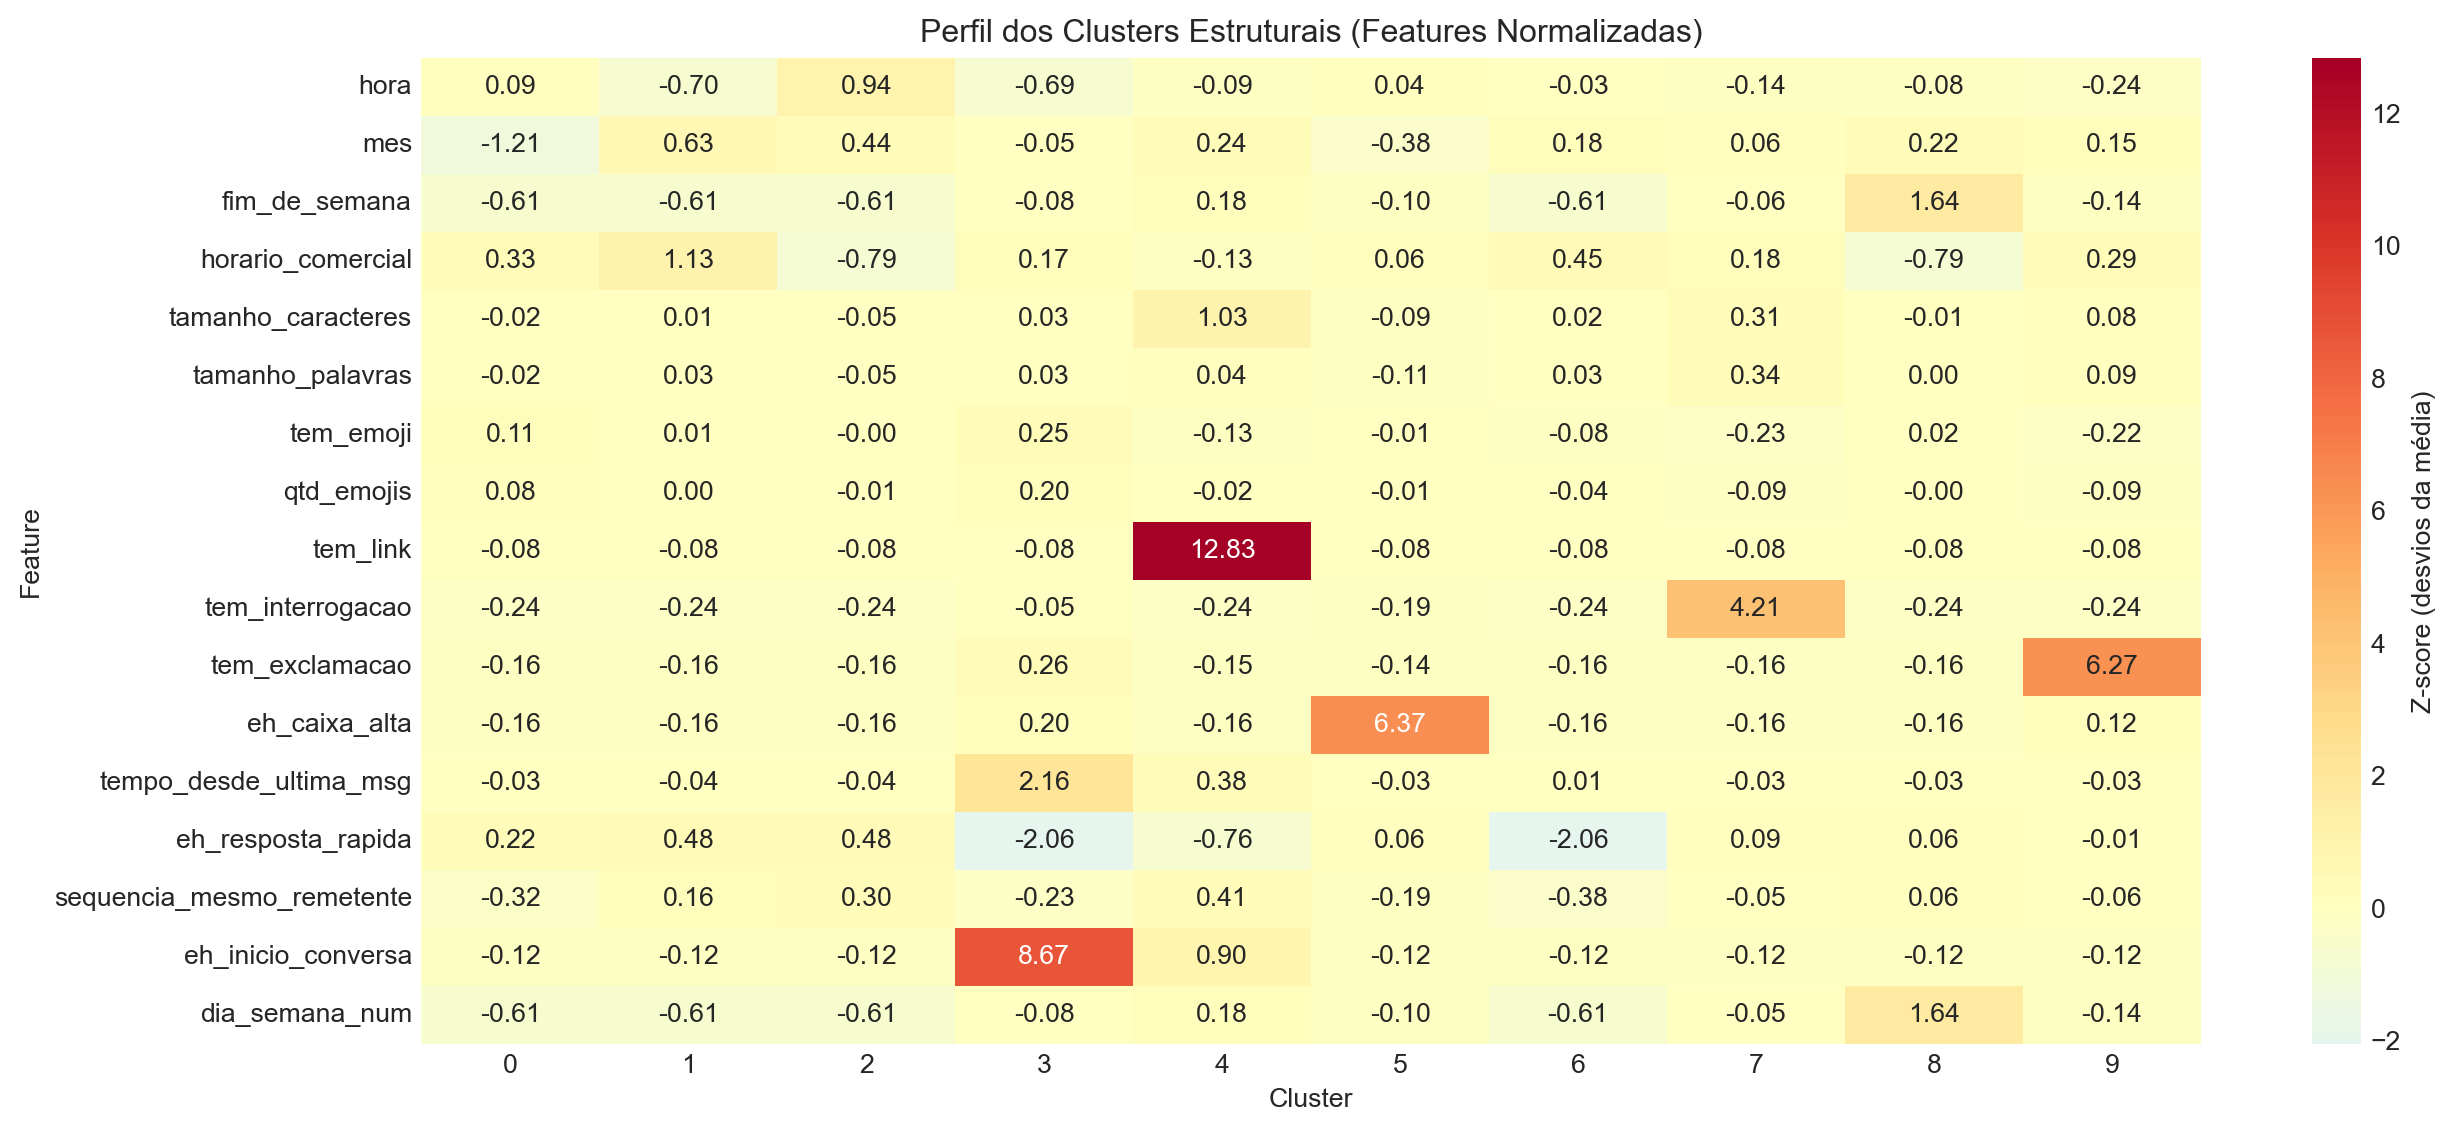
## 2.5 Perfil dos Clusters

```{python}
#| label: cluster-profiles
#| fig-cap: "Perfil médio normalizado de cada cluster"

# Calcula médias por cluster usando chunks para economizar memória
cluster_profiles_list = []

for cluster_id in range(K_ESTRUTURAL):
    mask = df['cluster_estrutural'] == cluster_id
    cluster_data = X_scaled[mask]

    # Processa em chunks se necessário
    if len(cluster_data) > CHUNK_SIZE:
        means = []
        for i in range(0, len(cluster_data), CHUNK_SIZE):
            chunk = cluster_data[i:i+CHUNK_SIZE]
            means.append(chunk.mean(axis=0))
        cluster_mean = np.mean(means, axis=0)
    else:
        cluster_mean = cluster_data.mean(axis=0)

    cluster_profiles_list.append(cluster_mean)

cluster_profiles = pd.DataFrame(
    cluster_profiles_list,
    columns=features_disponiveis,
    index=range(K_ESTRUTURAL)
)

# Heatmap
fig, ax = plt.subplots(figsize=(14, 6))
sns.heatmap(
    cluster_profiles.T,
    cmap='RdYlBu_r',
    center=0,
    annot=True,
    fmt='.2f',
    ax=ax,
    cbar_kws={'label': 'Z-score (desvios da média)'}
)
ax.set_xlabel('Cluster')
ax.set_ylabel('Feature')
ax.set_title('Perfil dos Clusters Estruturais (Features Normalizadas)')
plt.tight_layout()
plt.show()
```

```{python}
#| label: cluster-interpretation

# Gera interpretação automática baseada nas features dominantes
print("📋 **Interpretação dos Clusters:**\n")

for cluster_id in range(K_ESTRUTURAL):
    profile = cluster_profiles.loc[cluster_id]
    count = cluster_counts.get(cluster_id, 0)

    # Features mais altas e mais baixas
    top_features = profile.nlargest(3)
    bottom_features = profile.nsmallest(3)

    print(f"**Cluster {cluster_id}** ({count:,} mensagens)")
    print(f"  📈 Características altas: {', '.join(top_features.index.tolist())}")
    print(f"  📉 Características baixas: {', '.join(bottom_features.index.tolist())}")
    print()
```

## 2.6 Clusters por Participante

```{python}
#| label: clusters-by-participant
#| fig-cap: "Distribuição de clusters por participante"

if 'remetente' in df.columns:
    crosstab = pd.crosstab(df['remetente'], df['cluster_estrutural'], normalize='index') * 100

    fig = px.bar(
        crosstab,
        barmode='group',
        labels={'value': '% das Mensagens', 'cluster_estrutural': 'Cluster'},
        title='Distribuição de Clusters por Participante (%)',
        color_discrete_sequence=px.colors.qualitative.Set2
    )
    fig.update_layout(legend_title='Cluster')
    fig.show()
```

## 2.7 Visualização 2D (PCA)

```{python}
#| label: pca-visualization
#| fig-cap: "Projeção PCA dos clusters estruturais"

# Usa amostra para PCA (performance)
pca_sample_size = min(5000, len(X_scaled))
pca_idx = np.random.choice(len(X_scaled), pca_sample_size, replace=False)
X_pca_sample = X_scaled[pca_idx]
labels_sample = np.array(df['cluster_estrutural'])[pca_idx]

# Reduz para 2D com PCA
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X_pca_sample)

# Variância explicada
var_explained = pca.explained_variance_ratio_

# Cria DataFrame para plot
df_pca = pd.DataFrame({
    'PC1': X_pca[:, 0],
    'PC2': X_pca[:, 1],
    'Cluster': labels_sample.astype(str),
    'Remetente': df['remetente'].iloc[pca_idx].values if 'remetente' in df.columns else 'N/A'
})

# Plot
fig = px.scatter(
    df_pca,
    x='PC1', y='PC2',
    color='Cluster',
    hover_data=['Remetente'],
    title=f'Clusters Estruturais em 2D (PCA: {var_explained[0]:.1%} + {var_explained[1]:.1%} = {sum(var_explained):.1%} variância)',
    color_discrete_sequence=px.colors.qualitative.Set2,
    opacity=0.6
)
fig.update_traces(marker=dict(size=5))
fig.show()
```

------------------------------------------------------------------------

# 3. Clustering Semântico (Embeddings)

::: {.callout-note}
## Pré-requisito
Esta seção requer os arquivos de embeddings (`.npy`) gerados pelos notebooks `04f/g/h`.
Usamos MPNet (768d) como padrão por ter melhor qualidade.
:::

```{python}
#| label: check-embeddings

# Arquivos de embeddings disponíveis
EMBEDDINGS_FILES = {
    'mpnet': PATHS['processed'] / 'message_embeddings_mpnet.npy',      # 768d - melhor qualidade
    'minilm': PATHS['processed'] / 'message_embeddings_minilm.npy',    # 384d - mais rápido
    'distiluse': PATHS['processed'] / 'message_embeddings_distiluse.npy'  # 512d - balanceado
}

# Verifica quais existem
available_embeddings = {k: v for k, v in EMBEDDINGS_FILES.items() if v.exists()}

if available_embeddings:
    print("✅ Embeddings disponíveis:")
    for name, path in available_embeddings.items():
        size_mb = path.stat().st_size / 1024 / 1024
        print(f"   • {name}: {path.name} ({size_mb:.1f} MB)")

    # Escolhe o melhor disponível (ordem: mpnet > distiluse > minilm)
    for preferred in ['mpnet', 'distiluse', 'minilm']:
        if preferred in available_embeddings:
            EMBEDDING_CHOICE = preferred
            EMBEDDING_FILE = available_embeddings[preferred]
            break

    print(f"\n🎯 Usando: {EMBEDDING_CHOICE.upper()}")
    has_embeddings = True
else:
    print("⚠️ Nenhum arquivo de embeddings encontrado.")
    print("   Execute um dos notebooks 04f/g/h para gerar embeddings.")
    has_embeddings = False
```

```{python}
#| label: load-embeddings
#| output: false

if has_embeddings:
    # Carrega embeddings do arquivo .npy usando memory-mapping para economizar RAM
    # np.load com mmap_mode='r' não carrega tudo na memória de uma vez
    embeddings_full = np.load(EMBEDDING_FILE, mmap_mode='r')

    n_embeddings = len(embeddings_full)
    n_dims = embeddings_full.shape[1]

    # Verifica consistência com mensagens TEXT
    n_texto = (df['grupo_mensagem'] == 'TEXT').sum()

    print(f"📊 Embeddings carregados: {n_embeddings:,} x {n_dims} dimensões")
    print(f"   Mensagens TEXT no df: {n_texto:,}")

    if n_texto != n_embeddings:
        print(f"   ⚠️ Diferença detectada - usando min({n_texto:,}, {n_embeddings:,}) = {min(n_texto, n_embeddings):,}")
```

```{python}
#| label: semantic-sample
#| eval: !expr has_embeddings

print(f"📊 Embeddings: {n_embeddings:,} mensagens x {n_dims} dimensões")
print(f"   (apenas mensagens de TEXTO possuem embeddings)")

# Usa amostra para determinar K ótimo (economiza memória)
sample_size = min(SAMPLE_SIZE_ELBOW, n_embeddings)

np.random.seed(42)
sample_indices = np.random.choice(n_embeddings, sample_size, replace=False)

# Carrega apenas a amostra na memória
X_emb_sample = embeddings_full[sample_indices].copy()

print(f"   Amostra para análise: {sample_size:,} ({sample_size/n_embeddings*100:.1f}%)")
```

```{python}
#| label: semantic-elbow
#| eval: !expr has_embeddings
#| fig-cap: "Determinação do número de clusters para embeddings"

# Testa diferentes K para embeddings
K_range_emb = range(2, 11)
silhouettes_emb = []

print("🔄 Testando K de 2 a 10...")

for k in K_range_emb:
    kmeans = MiniBatchKMeans(
        n_clusters=k,
        random_state=42,
        batch_size=BATCH_SIZE_KMEANS,
        n_init=3
    )
    labels = kmeans.fit_predict(X_emb_sample)
    score = silhouette_score(X_emb_sample, labels)
    silhouettes_emb.append(score)

# Plot
fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(list(K_range_emb), silhouettes_emb, 'go-', linewidth=2, markersize=8)
ax.set_xlabel('Número de Clusters (K)')
ax.set_ylabel('Silhouette Score')
ax.set_title(f'Silhouette Score para Clustering Semântico ({EMBEDDING_CHOICE.upper()})')
ax.set_xticks(list(K_range_emb))

best_k_emb = list(K_range_emb)[np.argmax(silhouettes_emb)]
ax.axvline(x=best_k_emb, color='red', linestyle='--', alpha=0.7, label=f'Melhor K = {best_k_emb}')
ax.legend()

plt.tight_layout()
plt.show()

print(f"📊 Melhor K pelo Silhouette Score: {best_k_emb}")
```

```{python}
#| label: semantic-final
#| eval: !expr has_embeddings
#| output: false

# Clustering final nos embeddings
K_SEMANTICO = best_k_emb

kmeans_semantico = MiniBatchKMeans(
    n_clusters=K_SEMANTICO,
    random_state=42,
    batch_size=BATCH_SIZE_KMEANS,
    n_init=3
)

# Fit na amostra (já está em memória)
kmeans_semantico.fit(X_emb_sample)

# Predict em chunks para economizar memória
print(f"🔄 Aplicando clusters ao dataset completo em chunks...")

cluster_labels_semantic = np.zeros(n_embeddings, dtype=np.int32)

n_chunks = (n_embeddings + CHUNK_SIZE - 1) // CHUNK_SIZE
for i in range(n_chunks):
    start_idx = i * CHUNK_SIZE
    end_idx = min((i + 1) * CHUNK_SIZE, n_embeddings)

    # Carrega chunk do mmap
    chunk = embeddings_full[start_idx:end_idx].copy()
    chunk_labels = kmeans_semantico.predict(chunk)
    cluster_labels_semantic[start_idx:end_idx] = chunk_labels

# Adiciona ao dataframe principal
# IMPORTANTE: Apenas mensagens de TEXTO têm embeddings
# Recalcula máscara aqui para garantir que está disponível
mask_texto = df['grupo_mensagem'] == 'TEXT'
indices_texto = df.index[mask_texto].tolist()

# Inicializa com NaN para todas as mensagens
df['cluster_semantico'] = pd.NA

# Atribui clusters apenas às mensagens de TEXTO (na ordem do índice)
# Os embeddings estão na mesma ordem que as mensagens TEXT no df original
for i in range(min(len(indices_texto), n_embeddings)):
    idx = indices_texto[i]
    df.loc[idx, 'cluster_semantico'] = cluster_labels_semantic[i]

# Converte para Int32 (nullable integer)
df['cluster_semantico'] = df['cluster_semantico'].astype('Int32')

print(f"✅ Clusters atribuídos a {(~df['cluster_semantico'].isna()).sum():,} mensagens")

# Score usando a amostra
score_semantico = silhouette_score(X_emb_sample, kmeans_semantico.predict(X_emb_sample))
```

```{python}
#| label: semantic-result
#| eval: !expr has_embeddings

result_emb = [
    {'Métrica': 'Modelo de Embedding', 'Valor': EMBEDDING_CHOICE.upper()},
    {'Métrica': 'Dimensões', 'Valor': f'{n_dims}'},
    {'Métrica': 'Número de Clusters', 'Valor': f'{K_SEMANTICO}'},
    {'Métrica': 'Silhouette Score (amostra)', 'Valor': f'{score_semantico:.3f}'},
    {'Métrica': 'Interpretação', 'Valor': 'Bom' if score_semantico > 0.5 else 'Moderado' if score_semantico > 0.25 else 'Fraco'},
]

display(pd.DataFrame(result_emb).style.hide(axis='index'))
```

## 3.1 Distribuição dos Clusters Semânticos

```{python}
#| label: semantic-distribution
#| eval: !expr has_embeddings
#| fig-cap: "Distribuição de mensagens por cluster semântico"

cluster_counts_sem = df['cluster_semantico'].value_counts().sort_index()

fig = px.bar(
    x=cluster_counts_sem.index,
    y=cluster_counts_sem.values,
    labels={'x': 'Cluster', 'y': 'Quantidade de Mensagens'},
    title=f'Distribuição por Cluster Semântico ({EMBEDDING_CHOICE.upper()})',
    color=cluster_counts_sem.index.astype(str),
    color_discrete_sequence=px.colors.qualitative.Pastel
)
fig.update_layout(showlegend=False, xaxis_tickmode='linear')
fig.show()
```

## 3.2 Visualização 2D (PCA nos Embeddings)

```{python}
#| label: semantic-pca
#| eval: !expr has_embeddings
#| fig-cap: "Projeção PCA dos clusters semânticos"

# Usa a amostra que já está em memória
pca_emb = PCA(n_components=2)
X_pca_emb = pca_emb.fit_transform(X_emb_sample)

var_explained_emb = pca_emb.explained_variance_ratio_

# Labels da amostra
labels_sample_emb = cluster_labels_semantic[sample_indices]

df_pca_emb = pd.DataFrame({
    'PC1': X_pca_emb[:, 0],
    'PC2': X_pca_emb[:, 1],
    'Cluster': labels_sample_emb.astype(str)
})

fig = px.scatter(
    df_pca_emb,
    x='PC1', y='PC2',
    color='Cluster',
    title=f'Clusters Semânticos em 2D (PCA: {var_explained_emb[0]:.1%} + {var_explained_emb[1]:.1%} variância)',
    color_discrete_sequence=px.colors.qualitative.Pastel,
    opacity=0.6
)
fig.update_traces(marker=dict(size=5))
fig.show()
```

------------------------------------------------------------------------

# 4. Comparação: Estrutural vs Semântico

::: {.callout-note}
Esta seção só é executada se ambos os clusterings estiverem disponíveis.
:::

```{python}
#| label: comparison-check
#| output: false

# Verifica se temos ambos os clusterings (ambos estão em df agora)
has_both = ('cluster_estrutural' in df.columns and
            'cluster_semantico' in df.columns)
```

```{python}
#| label: comparison-matrix
#| eval: !expr has_both
#| fig-cap: "Matriz de confusão entre clusters estruturais e semânticos"

# Ambos os clusters estão no mesmo df agora
df_compare = df[['cluster_estrutural', 'cluster_semantico']].copy()

# Remove NaN (mensagens sem embedding não têm cluster semântico)
df_compare = df_compare.dropna()

print(f"📊 Comparando {len(df_compare):,} mensagens (apenas TEXT com embeddings)")
print(f"   ({len(df_compare)/len(df)*100:.1f}% do total)\n")

# Crosstab
confusion = pd.crosstab(
    df_compare['cluster_estrutural'],
    df_compare['cluster_semantico'],
    normalize='all'
) * 100

# Heatmap
fig, ax = plt.subplots(figsize=(8, 6))
sns.heatmap(
    confusion,
    annot=True,
    fmt='.1f',
    cmap='Blues',
    ax=ax,
    cbar_kws={'label': '% do Total'}
)
ax.set_xlabel('Cluster Semântico')
ax.set_ylabel('Cluster Estrutural')
ax.set_title('Overlap entre Abordagens de Clustering')
plt.tight_layout()
plt.show()
```

```{python}
#| label: comparison-insights
#| eval: !expr has_both

print("📊 **Insights da Comparação:**\n")

# Calcula concordância
max_overlap = confusion.max().max()
print(f"• Maior overlap entre clusters: {max_overlap:.1f}%")

# Identifica pares mais correlacionados
for i in range(len(confusion)):
    j = confusion.iloc[i].argmax()
    overlap = confusion.iloc[i, j]
    print(f"• Cluster Estrutural {i} ↔ Cluster Semântico {j}: {overlap:.1f}%")
```

------------------------------------------------------------------------

# 5. Análise Lexical: N-Grams e TF-IDF

::: {.callout-note}
## Objetivo
Identificar as palavras-chave e expressões que caracterizam e diferenciam cada cluster semântico.
- **N-Grams**: palavras/frases mais frequentes em cada cluster
- **TF-IDF**: termos que distinguem cada cluster dos demais
:::

## 5.1 Setup e Preprocessamento

```{python}
#| label: lexical-setup
#| output: false

# Importações para análise textual
from sklearn.feature_extraction.text import CountVectorizer, TfidfVectorizer
import re

# Nome da coluna de texto
COLUNA_TEXTO = 'conteudo'

# Verifica se temos dados para análise lexical
has_lexical_data = (has_both and COLUNA_TEXTO in df.columns)

if has_lexical_data:
    # Filtra apenas mensagens TEXT com cluster semântico
    df_lexical = df[df['cluster_semantico'].notna()].copy()
    print(f"✅ {len(df_lexical):,} mensagens disponíveis para análise lexical")
else:
    print(f"⚠️ Dados insuficientes para análise lexical")
    if COLUNA_TEXTO not in df.columns:
        print(f"   Coluna '{COLUNA_TEXTO}' não encontrada no dataframe")
```

```{python}
#| label: lexical-preprocessing
#| eval: !expr has_lexical_data
#| output: false

def preprocess_text(text):
    """
    Preprocessamento básico para análise de n-grams
    """
    if pd.isna(text):
        return ""

    text = str(text).lower()
    text = re.sub(r'http\S+|www\S+', '', text)  # URLs
    text = re.sub(r'@\w+', '', text)  # Menções
    text = re.sub(r'#\w+', '', text)  # Hashtags
    text = re.sub(r'\b\d+\b', '', text)  # Números isolados
    text = re.sub(r'[^\w\s]', ' ', text)  # Pontuação
    text = re.sub(r'\s+', ' ', text).strip()  # Espaços extras

    return text

# Aplica preprocessamento
df_lexical['texto_limpo'] = df_lexical[COLUNA_TEXTO].apply(preprocess_text)
print("✅ Preprocessamento concluído")
```

```{python}
#| label: ngrams-function
#| eval: !expr has_lexical_data
#| output: false

def extract_top_ngrams(texts, n=1, top_k=20, stop_words='portuguese'):
    """
    Extrai os top K n-grams mais frequentes
    """
    vectorizer = CountVectorizer(
        ngram_range=(n, n),
        max_features=top_k,
        stop_words=stop_words,
        min_df=2
    )

    try:
        X = vectorizer.fit_transform(texts)
        vocab = vectorizer.get_feature_names_out()
        frequencies = X.sum(axis=0).A1

        return pd.DataFrame({
            'ngram': vocab,
            'frequencia': frequencies
        }).sort_values('frequencia', ascending=False)
    except:
        return pd.DataFrame()
```

## 5.2 Análise de N-Grams

### 5.2.1 Unigrams (Palavras Individuais)

```{python}
#| label: ngrams-unigrams
#| eval: !expr has_lexical_data

print("🔤 TOP 20 UNIGRAMS POR CLUSTER SEMÂNTICO\n")
print("=" * 70)

# Obtém clusters únicos (converte para int para evitar problemas com Int32)
clusters_unicos = sorted([int(x) for x in df_lexical['cluster_semantico'].dropna().unique()])
print(f"   Clusters encontrados: {clusters_unicos}")

# Converte coluna para int para comparação correta
df_lexical['cluster_semantico_int'] = df_lexical['cluster_semantico'].astype('Int32').astype(float).astype('Int32')

for cluster_id in clusters_unicos:
    # Usa .isin() para comparação mais robusta
    mask = df_lexical['cluster_semantico'].fillna(-999).astype(int) == cluster_id
    texts = df_lexical.loc[mask, 'texto_limpo']

    print(f"\n   Debug: Cluster {cluster_id} tem {len(texts)} mensagens")

    top_unigrams = extract_top_ngrams(texts, n=1, top_k=20)

    if not top_unigrams.empty:
        n_msgs = len(texts)
        pct = n_msgs / len(df_lexical) * 100

        print(f"\n📍 CLUSTER {cluster_id} ({n_msgs:,} mensagens - {pct:.1f}%)")
        print(f"   Top 10: {', '.join(top_unigrams['ngram'].head(10).tolist())}")

print("\n" + "=" * 70)
```

### 5.2.2 Bigrams (Pares de Palavras)

```{python}
#| label: ngrams-bigrams
#| eval: !expr has_lexical_data

print("🔤 TOP 15 BIGRAMS POR CLUSTER SEMÂNTICO\n")
print("=" * 70)

for cluster_id in clusters_unicos:
    mask = df_lexical['cluster_semantico'].fillna(-999).astype(int) == cluster_id
    texts = df_lexical.loc[mask, 'texto_limpo']

    top_bigrams = extract_top_ngrams(texts, n=2, top_k=15)

    if not top_bigrams.empty:
        print(f"\n📍 CLUSTER {cluster_id}")
        print(f"   Top 10: {', '.join(top_bigrams['ngram'].head(10).tolist())}")

print("\n" + "=" * 70)
```

### 5.2.3 Trigrams (Expressões de Três Palavras)

```{python}
#| label: ngrams-trigrams
#| eval: !expr has_lexical_data

print("🔤 TOP 10 TRIGRAMS POR CLUSTER SEMÂNTICO\n")
print("=" * 70)

for cluster_id in clusters_unicos:
    mask = df_lexical['cluster_semantico'].fillna(-999).astype(int) == cluster_id
    texts = df_lexical.loc[mask, 'texto_limpo']

    top_trigrams = extract_top_ngrams(texts, n=3, top_k=10)

    if not top_trigrams.empty:
        print(f"\n📍 CLUSTER {cluster_id}")
        print(f"   Top 8: {', '.join(top_trigrams['ngram'].head(8).tolist())}")

print("\n" + "=" * 70)
```

### 5.2.4 Visualização Comparativa

```{python}
#| label: ngrams-visualization
#| eval: !expr has_lexical_data
#| fig-cap: "Top 10 palavras por cluster semântico"

# Visualiza TOP 10 unigrams de cada cluster lado a lado
n_clusters = len(clusters_unicos)
fig, axes = plt.subplots(1, n_clusters, figsize=(5*n_clusters, 6))

if n_clusters == 1:
    axes = [axes]

for idx, cluster_id in enumerate(clusters_unicos):
    mask = df_lexical['cluster_semantico'].fillna(-999).astype(int) == cluster_id
    texts = df_lexical.loc[mask, 'texto_limpo']
    top_words = extract_top_ngrams(texts, n=1, top_k=10)

    if not top_words.empty:
        axes[idx].barh(range(len(top_words)), top_words['frequencia'])
        axes[idx].set_yticks(range(len(top_words)))
        axes[idx].set_yticklabels(top_words['ngram'])
        axes[idx].invert_yaxis()
        axes[idx].set_xlabel('Frequência')
        axes[idx].set_title(f'Cluster {cluster_id}\n({len(texts):,} msgs)')
        axes[idx].grid(axis='x', alpha=0.3)

plt.tight_layout()
plt.show()
```

## 5.3 Análise TF-IDF (Termos Distintivos)

::: {.callout-tip}
## Interpretação TF-IDF
Enquanto N-Grams mostram o que é **mais falado** em cada cluster, TF-IDF mostra o que é **característico** de cada cluster (frequente nele, raro nos outros).
:::

```{python}
#| label: tfidf-setup
#| eval: !expr has_lexical_data
#| output: false

# Prepara documentos: concatena todas as mensagens de cada cluster
cluster_documents = []
cluster_ids_tfidf = []

for cluster_id in clusters_unicos:
    mask = df_lexical['cluster_semantico'].fillna(-999).astype(int) == cluster_id
    texts = df_lexical.loc[mask, 'texto_limpo']
    combined_text = ' '.join(texts.tolist())
    cluster_documents.append(combined_text)
    cluster_ids_tfidf.append(cluster_id)

print(f"✅ Preparados {len(cluster_documents)} documentos (1 por cluster)")
```

### 5.3.1 TF-IDF Unigrams

```{python}
#| label: tfidf-unigrams
#| eval: !expr has_lexical_data

# TF-IDF para UNIGRAMS
tfidf_vectorizer_1 = TfidfVectorizer(
    ngram_range=(1, 1),
    max_features=100,
    stop_words='portuguese',
    min_df=1
)

tfidf_matrix_1 = tfidf_vectorizer_1.fit_transform(cluster_documents)
feature_names_1 = tfidf_vectorizer_1.get_feature_names_out()

print("🎯 TOP 15 PALAVRAS DISTINTIVAS (TF-IDF) POR CLUSTER\n")
print("=" * 70)

for idx, cluster_id in enumerate(cluster_ids_tfidf):
    scores = tfidf_matrix_1[idx].toarray().flatten()
    top_indices = scores.argsort()[-15:][::-1]
    top_words = [(feature_names_1[i], scores[i]) for i in top_indices]

    print(f"\n📍 CLUSTER {cluster_id}")
    for word, score in top_words[:10]:
        print(f"   • {word}: {score:.3f}")

print("\n" + "=" * 70)
```

### 5.3.2 TF-IDF Bigrams

```{python}
#| label: tfidf-bigrams
#| eval: !expr has_lexical_data

# TF-IDF para BIGRAMS
tfidf_vectorizer_2 = TfidfVectorizer(
    ngram_range=(2, 2),
    max_features=100,
    stop_words='portuguese',
    min_df=1
)

tfidf_matrix_2 = tfidf_vectorizer_2.fit_transform(cluster_documents)
feature_names_2 = tfidf_vectorizer_2.get_feature_names_out()

print("🎯 TOP 10 FRASES DISTINTIVAS (TF-IDF) POR CLUSTER\n")
print("=" * 70)

for idx, cluster_id in enumerate(cluster_ids_tfidf):
    scores = tfidf_matrix_2[idx].toarray().flatten()
    top_indices = scores.argsort()[-10:][::-1]
    top_phrases = [(feature_names_2[i], scores[i]) for i in top_indices]

    print(f"\n📍 CLUSTER {cluster_id}")
    for phrase, score in top_phrases[:8]:
        print(f"   • \"{phrase}\": {score:.3f}")

print("\n" + "=" * 70)
```

### 5.3.3 Heatmap TF-IDF

```{python}
#| label: tfidf-heatmap
#| eval: !expr has_lexical_data
#| fig-cap: "Heatmap TF-IDF: top 20 palavras mais distintivas entre clusters"

# Seleciona top 20 features baseado na variância entre clusters
variances = np.var(tfidf_matrix_1.toarray(), axis=0)
top_variance_indices = variances.argsort()[-20:][::-1]

# Matriz para heatmap
heatmap_data = tfidf_matrix_1[:, top_variance_indices].toarray()
heatmap_words = feature_names_1[top_variance_indices]

# Plot
fig, ax = plt.subplots(figsize=(10, 8))
sns.heatmap(
    heatmap_data.T,
    xticklabels=[f'Cluster {i}' for i in cluster_ids_tfidf],
    yticklabels=heatmap_words,
    cmap='YlOrRd',
    annot=True,
    fmt='.2f',
    cbar_kws={'label': 'TF-IDF Score'},
    ax=ax,
    linewidths=0.5
)
ax.set_title('Top 20 Palavras Distintivas por Cluster (TF-IDF)', fontsize=14, pad=20)
ax.set_xlabel('Cluster Semântico', fontsize=12)
ax.set_ylabel('Palavra', fontsize=12)
plt.tight_layout()
plt.show()
```

## 5.4 Resumo Comparativo

```{python}
#| label: lexical-summary
#| eval: !expr has_lexical_data

print("📊 RESUMO COMPARATIVO: FREQUÊNCIA vs DISTINTIVIDADE\n")
print("=" * 80)

for cluster_id in cluster_ids_tfidf:
    mask = df_lexical['cluster_semantico'].fillna(-999).astype(int) == cluster_id
    n_msgs = mask.sum()
    pct = n_msgs / len(df_lexical) * 100

    print(f"\n{'='*80}")
    print(f"🔹 CLUSTER {cluster_id} ({n_msgs:,} mensagens - {pct:.1f}%)")
    print(f"{'='*80}")

    # Top 5 palavras mais frequentes (N-Grams)
    texts = df_lexical.loc[mask, 'texto_limpo']
    top_freq = extract_top_ngrams(texts, n=1, top_k=5)

    if not top_freq.empty:
        print(f"\n   📈 Mais FREQUENTES:")
        for word in top_freq['ngram'].tolist():
            print(f"      • {word}")

    # Top 5 palavras distintivas (TF-IDF)
    idx = cluster_ids_tfidf.index(cluster_id)
    scores = tfidf_matrix_1[idx].toarray().flatten()
    top_indices = scores.argsort()[-5:][::-1]
    top_distinctive = [(feature_names_1[i], scores[i]) for i in top_indices]

    print(f"\n   🎯 Mais DISTINTIVAS:")
    for word, score in top_distinctive:
        print(f"      • {word} ({score:.3f})")

    # Top 3 bigrams distintivos
    scores_2 = tfidf_matrix_2[idx].toarray().flatten()
    top_indices_2 = scores_2.argsort()[-3:][::-1]
    top_phrases = [(feature_names_2[i], scores_2[i]) for i in top_indices_2]

    print(f"\n   💬 Frases características:")
    for phrase, score in top_phrases:
        print(f"      • \"{phrase}\" ({score:.3f})")

print("\n" + "=" * 80)
print("\n✅ Análise lexical concluída!")
print("   Use estes insights para nomear e caracterizar cada cluster semântico.")
```

------------------------------------------------------------------------

# 6. Próximos Passos

Com os clusters identificados, as próximas análises podem incluir:

1. **EDA por Cluster** — Explorar características de cada grupo
2. **Análise Temporal** — Como os clusters evoluem ao longo do tempo
3. **Radar Charts** — Perfis visuais de P1 vs P2 por cluster
4. **MCA** — Análise de correspondência para variáveis categóricas

```{python}
#| label: save-clusters
#| output: false

# Salva dataset com clusters
OUTPUT_FILE = PATHS['processed'] / 'messages_clustered.parquet'
df.to_parquet(OUTPUT_FILE, index=False)
```

```{python}
#| label: final-summary

print("✅ **Análise de Clustering Concluída**\n")
print(f"📁 Dataset salvo: messages_clustered.parquet")
print(f"   Clusters estruturais: {K_ESTRUTURAL}")
if has_embeddings and 'K_SEMANTICO' in dir():
    print(f"   Clusters semânticos: {K_SEMANTICO}")
    print(f"   Modelo de embeddings: {EMBEDDING_CHOICE.upper()}")
```

------------------------------------------------------------------------

::: {.callout-tip}
## Exportar Clusters

O dataset com clusters foi salvo em `messages_clustered.parquet`.
Use-o nos próximos notebooks para análises segmentadas.
:::