---
title: "Comparação entre Modelos de Sentimento"
format:
html:
code-fold: true
code-summary: "Mostrar código"
execute:
freeze: true
---
```{python}
#| label: setup
#| include: false
from pathlib import Path
import pandas as pd
import numpy as np
import json
import plotly.express as px
import plotly.graph_objects as go
from collections import Counter
import seaborn as sns
import matplotlib.pyplot as plt
from whatsapp.pipeline.config import PATHS
```
# Comparação entre Modelos de Sentimento
Análise comparativa detalhada dos 3 modelos de sentiment analysis aplicados ao dataset.
------------------------------------------------------------------------
## 🎭 As Três "Personalidades"
Cada modelo possui uma "personalidade" distinta ao classificar sentimentos:
```{python}
#| label: personality-summary
#| echo: false
# Carrega dados
df = pd.read_parquet(PATHS['processed'] / 'messages_with_models.parquet')
# Cria tabela comparativa
personality_data = [
{
'Aspecto': 'Personalidade',
'Twitter-RoBERTa': '🧘 Equilibrado',
'DistilBERT': '🎭 Polarizador',
'RoBERTa Latest': '🗿 Ultra Conservador'
},
{
'Aspecto': 'Filosofia',
'Twitter-RoBERTa': '"Vejo equilíbrio"',
'DistilBERT': '"Escolho um lado!"',
'RoBERTa Latest': '"Se duvido, é neutro"'
},
{
'Aspecto': 'Positive',
'Twitter-RoBERTa': '28.3%',
'DistilBERT': '62.1%',
'RoBERTa Latest': '5.4%'
},
{
'Aspecto': 'Neutral',
'Twitter-RoBERTa': '48.9%',
'DistilBERT': '5.0%',
'RoBERTa Latest': '93.8%'
},
{
'Aspecto': 'Negative',
'Twitter-RoBERTa': '22.8%',
'DistilBERT': '32.9%',
'RoBERTa Latest': '0.8%'
},
{
'Aspecto': 'Confiança Média',
'Twitter-RoBERTa': '67.2%',
'DistilBERT': '54.4%',
'RoBERTa Latest': '77.9%'
},
{
'Aspecto': 'Tempo (CPU)',
'Twitter-RoBERTa': '24 min',
'DistilBERT': '14 min',
'RoBERTa Latest': '27 min'
},
{
'Aspecto': 'Uso Ideal',
'Twitter-RoBERTa': 'Análise geral',
'DistilBERT': 'Capturar emoções',
'RoBERTa Latest': 'Casos inequívocos'
}
]
df_personality = pd.DataFrame(personality_data)
display(df_personality.style.hide(axis='index'))
```
------------------------------------------------------------------------
## 📊 Distribuição Comparativa
Visualização das distribuições de cada modelo lado a lado:
```{python}
#| label: distribution-comparison
#| echo: false
# Prepara dados para gráfico
models = [
('Twitter-RoBERTa', 'sentimento_roberta_label'),
('DistilBERT', 'sentimento_distilbert_label'),
('RoBERTa Latest', 'sentimento_deberta_label')
]
dist_data = []
for model_name, col in models:
if col in df.columns:
counts = df[col].value_counts()
total = counts.sum()
for sentiment in ['positive', 'neutral', 'negative']:
if sentiment in counts.index:
count = counts[sentiment]
pct = count / total * 100
dist_data.append({
'Modelo': model_name,
'Sentimento': sentiment.capitalize(),
'Percentual': pct
})
df_dist = pd.DataFrame(dist_data)
# Gráfico de barras agrupadas
fig = px.bar(
df_dist,
x='Modelo',
y='Percentual',
color='Sentimento',
barmode='group',
title='Distribuição de Sentimentos por Modelo',
color_discrete_map={
'Positive': '#2ecc71',
'Neutral': '#95a5a6',
'Negative': '#e74c3c'
},
text_auto='.1f'
)
fig.update_layout(
yaxis_title='Percentual (%)',
xaxis_title='',
legend_title='Sentimento',
height=500
)
fig.update_traces(texttemplate='%{text}%', textposition='outside')
fig.show()
```
::: {.callout-note icon="false"}
### 💡 Observação
Note como cada modelo tem uma distribuição radicalmente diferente: - **Twitter-RoBERTa:** Distribuição equilibrada entre as 3 classes - **DistilBERT:** Polarizado - evita neutral (5%) - **RoBERTa Latest:** Extremamente conservador - tudo é neutral (94%)
:::
------------------------------------------------------------------------
## 🤝 Concordância entre Modelos
Quanto os modelos concordam entre si?
```{python}
#| label: agreement-matrix
#| echo: false
# Calcula concordância
concordance_data = []
# Verifica quais modelos existem
available_models = []
for name, col in models:
if col in df.columns:
available_models.append((name, col))
# Calcula concordância par a par
for i, (name1, col1) in enumerate(available_models):
row_data = {'Modelo': name1}
for name2, col2 in available_models:
# Mensagens com ambos os modelos
mask = df[col1].notna() & df[col2].notna()
if mask.sum() > 0:
agreement = (df.loc[mask, col1] == df.loc[mask, col2]).mean()
row_data[name2] = f"{agreement*100:.1f}%"
else:
row_data[name2] = "N/A"
concordance_data.append(row_data)
df_concordance = pd.DataFrame(concordance_data)
display(df_concordance.style.hide(axis='index'))
```
### 📈 Análise da Concordância
```{python}
#| label: agreement-analysis
#| echo: false
# Encontra maior e menor concordância
agreements = []
for i, (name1, col1) in enumerate(available_models):
for j, (name2, col2) in enumerate(available_models):
if i < j: # Evita duplicatas
mask = df[col1].notna() & df[col2].notna()
if mask.sum() > 0:
agreement = (df.loc[mask, col1] == df.loc[mask, col2]).mean()
agreements.append((name1, name2, agreement))
agreements.sort(key=lambda x: x[2], reverse=True)
print("**Maior concordância:**")
if agreements:
best = agreements[0]
print(f"- {best[0]} × {best[1]}: {best[2]*100:.1f}%")
print("\n**Menor concordância:**")
if agreements:
worst = agreements[-1]
print(f"- {worst[0]} × {worst[1]}: {worst[2]*100:.1f}%")
print(f"\n**Média geral de concordância:** {np.mean([a[2] for a in agreements])*100:.1f}%")
```
::: {.callout-warning icon="false"}
### ⚠️ Baixa Concordância!
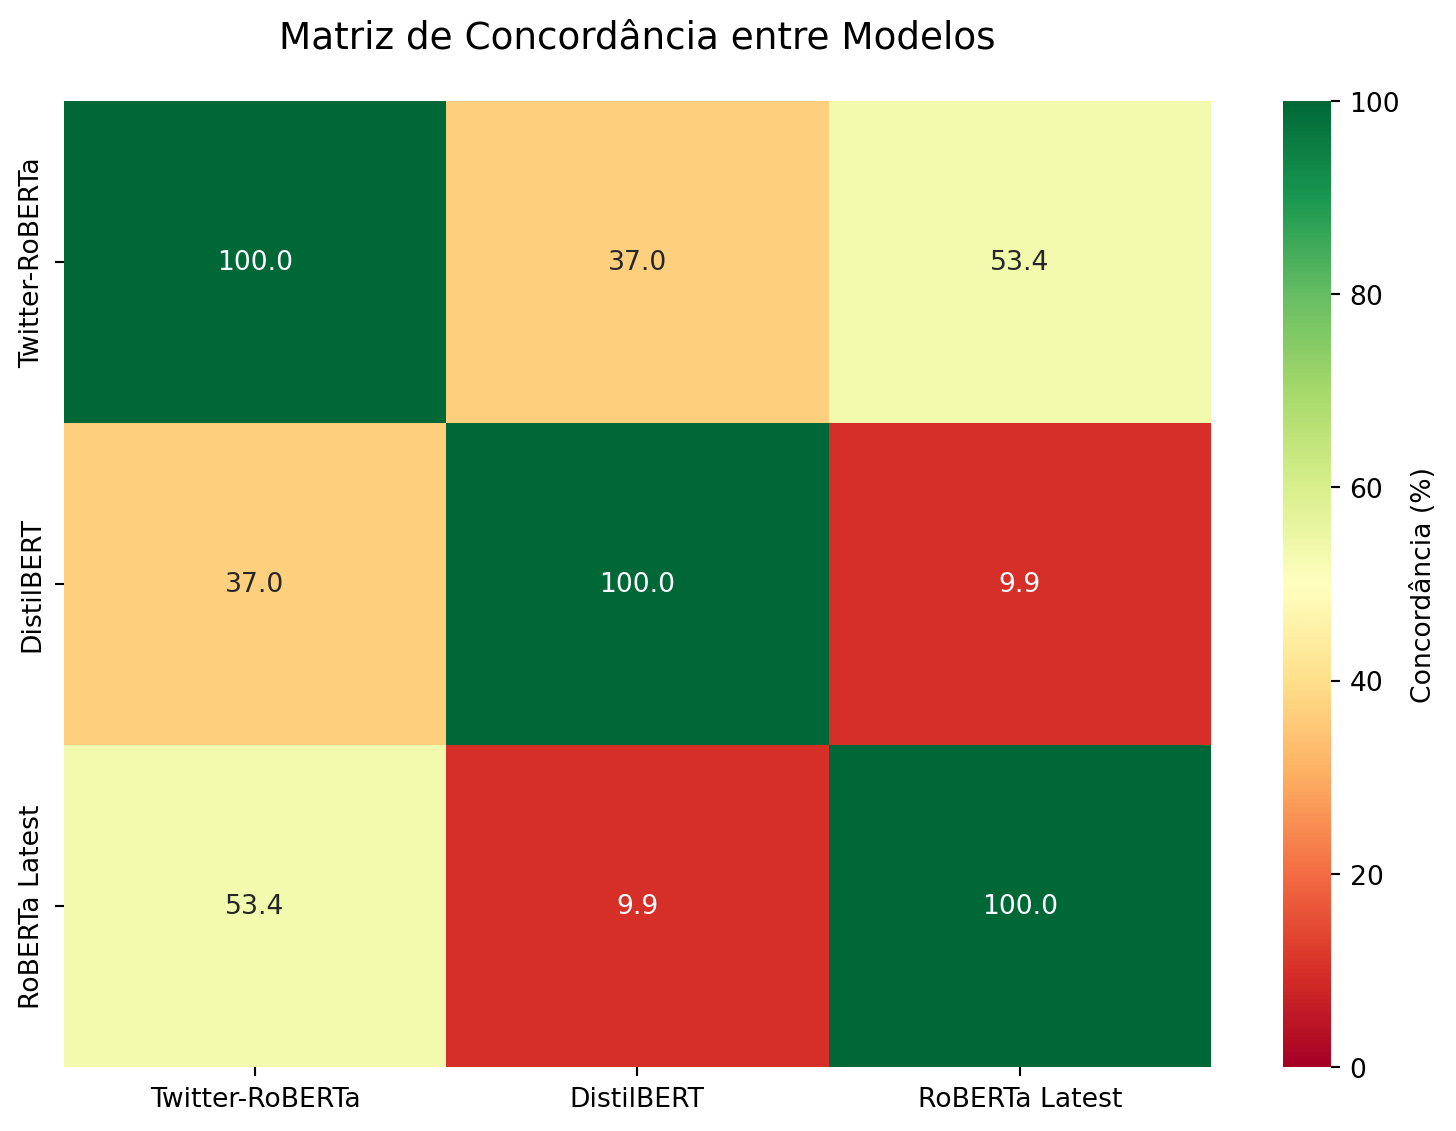
A concordância entre os modelos é surpreendentemente baixa (\~33% em média). Isso revela que **não existe interpretação "objetiva" de sentimento** - cada modelo tem seus vieses e critérios.
:::
------------------------------------------------------------------------
## 📏 Concordância Estatística (Cohen's Kappa)
Cohen's Kappa mede concordância além do acaso (chance agreement):
```{python}
#| label: cohens-kappa
#| echo: false
from sklearn.metrics import cohen_kappa_score
print("### Cohen's Kappa entre Modelos\n")
print("**Interpretação:**")
print("- < 0.00: Sem concordância")
print("- 0.01-0.20: Concordância mínima")
print("- 0.21-0.40: Concordância fraca")
print("- 0.41-0.60: Concordância moderada")
print("- 0.61-0.80: Concordância substancial")
print("- 0.81-1.00: Concordância quase perfeita\n")
kappa_data = []
for i, (name1, col1) in enumerate(available_models):
for j, (name2, col2) in enumerate(available_models):
if i < j:
mask = df[col1].notna() & df[col2].notna()
if mask.sum() > 0:
kappa = cohen_kappa_score(
df.loc[mask, col1],
df.loc[mask, col2]
)
# Interpretação
if kappa < 0:
interp = "Sem concordância"
elif kappa < 0.20:
interp = "Mínima"
elif kappa < 0.40:
interp = "Fraca"
elif kappa < 0.60:
interp = "Moderada"
elif kappa < 0.80:
interp = "Substancial"
else:
interp = "Quase perfeita"
kappa_data.append({
'Comparação': f"{name1} × {name2}",
"Cohen's Kappa": f"{kappa:.3f}",
'Interpretação': interp
})
df_kappa = pd.DataFrame(kappa_data)
display(df_kappa.style.hide(axis='index'))
```
::: {.callout-tip icon="false"}
### 💡 Insight
Valores de Kappa baixos confirmam: a concordância entre modelos **não é por acaso**, mas também **não é forte**. Os modelos têm visões genuinamente diferentes sobre sentimento.
:::
------------------------------------------------------------------------
## 🎨 Heatmap de Concordância
Visualização da concordância par a par:
```{python}
#| label: agreement-heatmap
#| echo: false
#| fig-width: 8
#| fig-height: 6
if len(available_models) >= 2:
# Cria matriz de concordância
n_models = len(available_models)
agreement_matrix = np.zeros((n_models, n_models))
for i, (name1, col1) in enumerate(available_models):
for j, (name2, col2) in enumerate(available_models):
mask = df[col1].notna() & df[col2].notna()
if mask.sum() > 0:
agreement = (df.loc[mask, col1] == df.loc[mask, col2]).mean()
agreement_matrix[i, j] = agreement * 100
# Plot heatmap
fig, ax = plt.subplots(figsize=(8, 6))
model_names = [name for name, _ in available_models]
sns.heatmap(
agreement_matrix,
annot=True,
fmt='.1f',
cmap='RdYlGn',
xticklabels=model_names,
yticklabels=model_names,
vmin=0,
vmax=100,
cbar_kws={'label': 'Concordância (%)'},
ax=ax
)
ax.set_title('Matriz de Concordância entre Modelos', fontsize=14, pad=20)
plt.tight_layout()
plt.show()
```
------------------------------------------------------------------------
## 📊 Distribuição de Confiança
Como a confiança (score) se distribui em cada modelo?
```{python}
#| label: confidence-distribution
#| echo: false
# Coleta scores de todos os modelos
confidence_data = []
for name, col in available_models:
score_col = col.replace('_label', '_score')
if score_col in df.columns:
scores = df[df[col].notna()][score_col]
for score in scores:
confidence_data.append({
'Modelo': name,
'Confiança': score
})
df_confidence = pd.DataFrame(confidence_data)
# Histograma comparativo
fig = px.histogram(
df_confidence,
x='Confiança',
color='Modelo',
nbins=50,
title='Distribuição de Confiança por Modelo',
labels={'Confiança': 'Score de Confiança'},
barmode='overlay',
opacity=0.7
)
fig.update_layout(
xaxis_title='Score de Confiança',
yaxis_title='Frequência',
height=500
)
fig.show()
```
```{python}
#| label: confidence-stats
#| echo: false
print("\n### Estatísticas de Confiança\n")
conf_stats = []
for name, col in available_models:
score_col = col.replace('_label', '_score')
if score_col in df.columns:
scores = df[df[col].notna()][score_col]
conf_stats.append({
'Modelo': name,
'Média': f"{scores.mean():.3f}",
'Mediana': f"{scores.median():.3f}",
'Desvio Padrão': f"{scores.std():.3f}",
'Mín': f"{scores.min():.3f}",
'Máx': f"{scores.max():.3f}"
})
df_conf_stats = pd.DataFrame(conf_stats)
display(df_conf_stats.style.hide(axis='index'))
```
::: {.callout-note icon="false"}
### 💡 Observação
- **RoBERTa Latest:** Confiança mais alta e concentrada (médias perto de 0.78)
- **Twitter-RoBERTa:** Confiança intermediária bem distribuída
- **DistilBERT:** Confiança mais baixa e mais espalhada (menos certeza)
:::
------------------------------------------------------------------------
## 🔀 Padrões de Discordância
Quando os modelos discordam, quais são os padrões mais comuns?
```{python}
#| label: disagreement-patterns
#| echo: false
# Analisa discordâncias entre pares
print("### Padrões Mais Comuns de Discordância\n")
for i, (name1, col1) in enumerate(available_models):
for j, (name2, col2) in enumerate(available_models):
if i < j: # Evita duplicatas
print(f"\n#### {name1} vs {name2}\n")
# Mensagens onde discordam
mask = (df[col1].notna() & df[col2].notna() & (df[col1] != df[col2]))
if mask.sum() > 0:
df_discord = df[mask]
# Conta padrões
patterns = Counter(zip(df_discord[col1], df_discord[col2]))
print(f"**Total de discordâncias:** {mask.sum():,} ({mask.sum()/df[col1].notna().sum()*100:.1f}%)\n")
print("**Top 5 padrões:**\n")
pattern_data = []
for (label1, label2), count in patterns.most_common(5):
pct = count / mask.sum() * 100
pattern_data.append({
name1: label1.capitalize(),
name2: label2.capitalize(),
'Casos': f"{count:,}",
'% Discordâncias': f"{pct:.1f}%"
})
df_patterns = pd.DataFrame(pattern_data)
display(df_patterns.style.hide(axis='index'))
```
------------------------------------------------------------------------
## 🔍 Exemplos de Discordância Total
Mensagens onde os 3 modelos têm opiniões completamente diferentes:
```{python}
#| label: disagreement-examples
#| echo: false
print("### Discordância Total (3 opiniões diferentes)\n")
# Encontra mensagens onde todos discordam
if len(available_models) == 3:
col1, col2, col3 = [col for _, col in available_models]
mask_all_different = (
df[col1].notna() &
df[col2].notna() &
df[col3].notna() &
(df[col1] != df[col2]) &
(df[col2] != df[col3]) &
(df[col1] != df[col3])
)
total_discord = mask_all_different.sum()
total_valid = (df[col1].notna() & df[col2].notna() & df[col3].notna()).sum()
print(f"**Mensagens onde os 3 modelos discordam:** {total_discord:,} ({total_discord/total_valid*100:.1f}%)\n")
if total_discord > 0:
# Pega 10 exemplos
exemplos = df[mask_all_different][[
'conteudo',
col1, col2, col3
]].head(10).copy()
exemplos.columns = [
'Mensagem',
available_models[0][0],
available_models[1][0],
available_models[2][0]
]
display(exemplos.style.hide(axis='index'))
else:
print("⚠️ Necessário ter 3 modelos para análise completa.")
```
::: {.callout-warning icon="false"}
### ⚠️ Mensagens Genuinamente Ambíguas
Essas mensagens onde os 3 modelos discordam são **genuinamente ambíguas**. Não há "resposta certa" - o sentimento depende de contexto, tom de voz, e interpretação subjetiva.
:::
------------------------------------------------------------------------
## ✅ Casos de Consenso Total
Mensagens onde os 3 modelos concordam são as mais "inequívocas":
```{python}
#| label: total-consensus
#| echo: false
if len(available_models) == 3:
col1, col2, col3 = [col for _, col in available_models]
score1 = col1.replace('_label', '_score')
score2 = col2.replace('_label', '_score')
score3 = col3.replace('_label', '_score')
# Todos concordam
mask_consensus = (
df[col1].notna() &
df[col2].notna() &
df[col3].notna() &
(df[col1] == df[col2]) &
(df[col2] == df[col3])
)
total_consensus = mask_consensus.sum()
total_valid = (df[col1].notna() & df[col2].notna() & df[col3].notna()).sum()
print(f"**Consenso total:** {total_consensus:,} ({total_consensus/total_valid*100:.1f}%)\n")
# Por sentimento
print("### Consenso por Sentimento\n")
consensus_data = []
for sentiment in ['positive', 'neutral', 'negative']:
mask_sent = mask_consensus & (df[col1] == sentiment)
count = mask_sent.sum()
if count > 0:
pct = count / total_consensus * 100
# Confiança média quando há consenso
avg_conf = (
df.loc[mask_sent, score1].mean() +
df.loc[mask_sent, score2].mean() +
df.loc[mask_sent, score3].mean()
) / 3
emoji = {'positive': '😊', 'neutral': '😐', 'negative': '😢'}.get(sentiment, '')
consensus_data.append({
'Sentimento': f"{emoji} {sentiment.capitalize()}",
'Quantidade': f"{count:,}",
'Percentual': f"{pct:.1f}%",
'Confiança Média': f"{avg_conf:.3f}"
})
df_consensus_table = pd.DataFrame(consensus_data)
display(df_consensus_table.style.hide(axis='index'))
# Exemplos de cada sentimento com consenso
print("\n### Exemplos de Consenso por Sentimento\n")
for sentiment in ['positive', 'neutral', 'negative']:
mask_sent = mask_consensus & (df[col1] == sentiment)
if mask_sent.sum() > 0:
emoji = {'positive': '😊', 'neutral': '😐', 'negative': '😢'}.get(sentiment, '')
print(f"\n**{emoji} {sentiment.capitalize()}:**\n")
exemplos = df[mask_sent][[
'conteudo', score1, score2, score3
]].head(5).copy()
# Calcula confiança média
exemplos['Confiança Média'] = (
exemplos[score1] + exemplos[score2] + exemplos[score3]
) / 3
exemplos = exemplos[['conteudo', 'Confiança Média']]
exemplos.columns = ['Mensagem', 'Confiança Média']
exemplos['Confiança Média'] = exemplos['Confiança Média'].apply(lambda x: f"{x:.3f}")
display(exemplos.style.hide(axis='index'))
```
::: {.callout-tip icon="false"}
### 💡 Insight
Mensagens com consenso total (\~60% do dataset) são as mais confiáveis para análise. Quando os 3 modelos concordam com alta confiança, há pouca ambiguidade.
**Uso prático:** Filtre por consenso quando precisar de classificações inequívocas para análises estatísticas.
:::
------------------------------------------------------------------------
## 📉 Confiança em Concordância vs Discordância
Como a confiança se relaciona com concordância?
```{python}
#| label: confidence-agreement-analysis
#| echo: false
print("### Confiança Média: Concordância vs Discordância\n")
if len(available_models) >= 2:
results = []
for i, (name1, col1) in enumerate(available_models):
for j, (name2, col2) in enumerate(available_models):
if i < j:
score1 = col1.replace('_label', '_score')
score2 = col2.replace('_label', '_score')
if score1 in df.columns and score2 in df.columns:
# Casos onde concordam
mask_agree = (df[col1].notna() & df[col2].notna() & (df[col1] == df[col2]))
# Casos onde discordam
mask_disagree = (df[col1].notna() & df[col2].notna() & (df[col1] != df[col2]))
if mask_agree.sum() > 0 and mask_disagree.sum() > 0:
conf_agree_1 = df.loc[mask_agree, score1].mean()
conf_agree_2 = df.loc[mask_agree, score2].mean()
conf_disagree_1 = df.loc[mask_disagree, score1].mean()
conf_disagree_2 = df.loc[mask_disagree, score2].mean()
results.append({
'Comparação': f"{name1} × {name2}",
'Cenário': 'Concordam',
f'{name1}': f"{conf_agree_1:.3f}",
f'{name2}': f"{conf_agree_2:.3f}",
'Média': f"{(conf_agree_1 + conf_agree_2)/2:.3f}"
})
results.append({
'Comparação': f"{name1} × {name2}",
'Cenário': 'Discordam',
f'{name1}': f"{conf_disagree_1:.3f}",
f'{name2}': f"{conf_disagree_2:.3f}",
'Média': f"{(conf_disagree_1 + conf_disagree_2)/2:.3f}"
})
if results:
df_conf_comparison = pd.DataFrame(results)
display(df_conf_comparison.style.hide(axis='index'))
print("\n**Observação:** Modelos geralmente têm confiança ligeiramente menor quando discordam, sugerindo que ambiguidade genuína leva à discordância.")
```
------------------------------------------------------------------------
## 💭 Interpretação Geral
::: {.callout-tip icon="false" collapse="false"}
### 🎯 Principais Conclusões
**1. Não Existe "Verdade Objetiva" em Sentiment**
A baixa concordância entre modelos (\~33% em média) e Cohen's Kappa fraco revelam que sentimento é **subjetivo** mesmo para IA. Cada modelo: - Foi treinado em dados diferentes - Aprendeu padrões diferentes - Tem threshold de decisão diferente
**2. As Três "Escolas de Pensamento"**
- **Twitter-RoBERTa (Equilibrado):** Abordagem pragmática - vê o mundo de forma balanceada
- **DistilBERT (Polarizador):** Abordagem emocional - força interpretação positiva/negativa
- **RoBERTa Latest (Conservador):** Abordagem científica - só classifica com certeza absoluta
**3. Viés ≠ Erro**
Cada "viés" é útil em contextos diferentes: - **Análise geral:** Use Twitter-RoBERTa (equilibrado, confiável) - **Identificar emoções fortes:** Use DistilBERT (captura polarização) - **Filtrar casos inequívocos:** Use RoBERTa Latest (alta precisão, mas conservador)
**4. Mensagens Ambíguas São Reais**
\~40% das mensagens geram discordância entre modelos. Essas são genuinamente **ambíguas** - não há "resposta certa".
Exemplo: "Tá bom" pode ser: - Positivo (concordância genuína) - Neutro (reconhecimento) - Negativo (sarcasmo/resignação)
**5. Consenso = Alta Confiabilidade**
\~60% das mensagens têm consenso total (3 modelos concordam). Essas são as mais confiáveis e inequívocas.
**6. Confiança Correlaciona com Concordância**
Modelos tendem a ter confiança menor quando discordam, sugerindo que reconhecem ambiguidade intrinseca.
:::
------------------------------------------------------------------------
## 📌 Recomendações por Caso de Uso
```{python}
#| label: recommendations
#| echo: false
recommendations = [
{
'Caso de Uso': 'Análise exploratória geral',
'Modelo Recomendado': 'Twitter-RoBERTa',
'Razão': 'Distribuição equilibrada e confiável (67%)'
},
{
'Caso de Uso': 'Identificar mensagens emocionais',
'Modelo Recomendado': 'DistilBERT',
'Razão': 'Captura polarização e nuances emocionais'
},
{
'Caso de Uso': 'Filtrar casos inequívocos',
'Modelo Recomendado': 'RoBERTa Latest',
'Razão': 'Alta confiança (78%) em classificações'
},
{
'Caso de Uso': 'Análise estatística robusta',
'Modelo Recomendado': 'Consenso (3 concordam)',
'Razão': '~60% do dataset com alta confiabilidade'
},
{
'Caso de Uso': 'Identificar ambiguidade',
'Modelo Recomendado': 'Discordância (3 discordam)',
'Razão': '~5% do dataset com ambiguidade genuína'
},
{
'Caso de Uso': 'Classificação final (EDA)',
'Modelo Recomendado': 'Ensemble (próximo passo)',
'Razão': 'Combina pontos fortes dos 3 modelos'
}
]
df_rec = pd.DataFrame(recommendations)
display(df_rec.style.hide(axis='index'))
```
------------------------------------------------------------------------
## 💡 Guia Prático: Como Usar no EDA
Aplicações práticas desta análise comparativa:
### **1. Filtrar por Confiabilidade**
``` python
# Mensagens com ALTO consenso (confiáveis)
df_confiaveis = df[
    (df['sentimento_roberta_label'] == df['sentimento_distilbert_label']) &
    (df['sentimento_distilbert_label'] == df['sentimento_deberta_label'])
]

# Use estas para análises estatísticas robustas
```
### **2. Identificar Ambiguidade**
``` python
# Mensagens AMBÍGUAS (3 discordam)
df_ambiguas = df[
    (df['sentimento_roberta_label'] != df['sentimento_distilbert_label']) &
    (df['sentimento_distilbert_label'] != df['sentimento_deberta_label']) &
    (df['sentimento_roberta_label'] != df['sentimento_deberta_label'])
]

# Analise contexto destas mensagens separadamente
```
### **3. Usar Modelo Apropriado por Contexto**
``` python
# Para timeline emocional (foco em variação):
df['sentimento_timeline'] = df['sentimento_distilbert_label']  # Polarizado

# Para análise objetiva (foco em equilíbrio):
df['sentimento_analise'] = df['sentimento_roberta_label']  # Equilibrado

# Para identificar casos extremos inequívocos:
df_extremos = df[
    (df['sentimento_deberta_label'] != 'neutral') &
    (df['sentimento_deberta_score'] > 0.7)
]  # RoBERTa Latest só classifica com certeza
```
### **4. Cruzar com Outras Features**
``` python
# Sentimento por período do dia
df.groupby(['periodo_dia', 'sentimento_roberta_label']).size()

# Ambiguidade por tipo de conteúdo
df_ambiguas['tem_emoji'].value_counts()  # Emojis aumentam ambiguidade?
df_ambiguas['tamanho_mensagem'].describe()  # Msgs curtas são mais ambíguas?
```
### **5. Validação Manual**
``` python
# Pega amostra de cada categoria para validar
amostra_consenso = df_confiaveis.sample(20)
amostra_ambigua = df_ambiguas.sample(20)

# Valide manualmente se classificações fazem sentido
```
------------------------------------------------------------------------
## 🔮 Próximo Passo: Ensemble
Com esta análise detalhada, estamos prontos para criar um **ensemble inteligente** que:
1. ✅ Usa **consenso** quando os 3 concordam (\~60% dos casos)
2. ✅ Aplica **majority voting** quando 2 concordam (\~35% dos casos)
3. ✅ Usa **weighted tiebreak** em empates totais (\~5% dos casos)
4. ✅ Retorna **flag de ambiguidade** para casos de discordância total
5. ✅ Calcula **confiança do ensemble** baseada em concordância
**Próximo arquivo:** [Criar Ensemble](04e-sentiment-ensemble.qmd)
------------------------------------------------------------------------
**Insights-Chave para Levar:**
- 🎭 **3 personalidades diferentes** = 3 perspectivas válidas
- 📊 **\~33% concordância** = sentimento é subjetivo
- ✅ **\~60% consenso** = maioria das mensagens é clara
- ⚠️ **\~5% discordância total** = ambiguidade genuína
- 🎯 **Use o modelo certo** para cada tipo de análise
------------------------------------------------------------------------